 Lens
AI 推理的终极控制平面: 一键部署、自动化基准测试与全栈集群监控。
亮点功能
最优性能
部署运行在 llm-d 之上:预填充/解码分离、感知 KV 缓存的路由、 KV 缓存向 CPU/SSD 分层卸载,以及基于延迟预测的路由, 在同样的 GPU 上提升吞吐并降低尾延迟。
多集群部署
在单一界面中规划、审批并执行跨 Kubernetes 集群的推理部署, 并支持具备智能体能力、按负载引导的放置策略。
引导式评估
设计基准测试实验,针对线上部署运行测试, 并分析和导出结果,无需手写脚本。
流量模拟
对推理端点重放已注册的请求轨迹, 在真实流量到来前验证行为与容量。
模型服务网关
将集群部署发布为兼容 OpenAI 的模型服务, 运行在集群共享网关之后(HTTPRoute → InferencePool → EPP), 并支持按模型配置选择策略。
内置治理能力
基于角色的访问控制、按集群的权限范围和审计日志, 覆盖从集群到模型服务的每一个页面。
可观测性
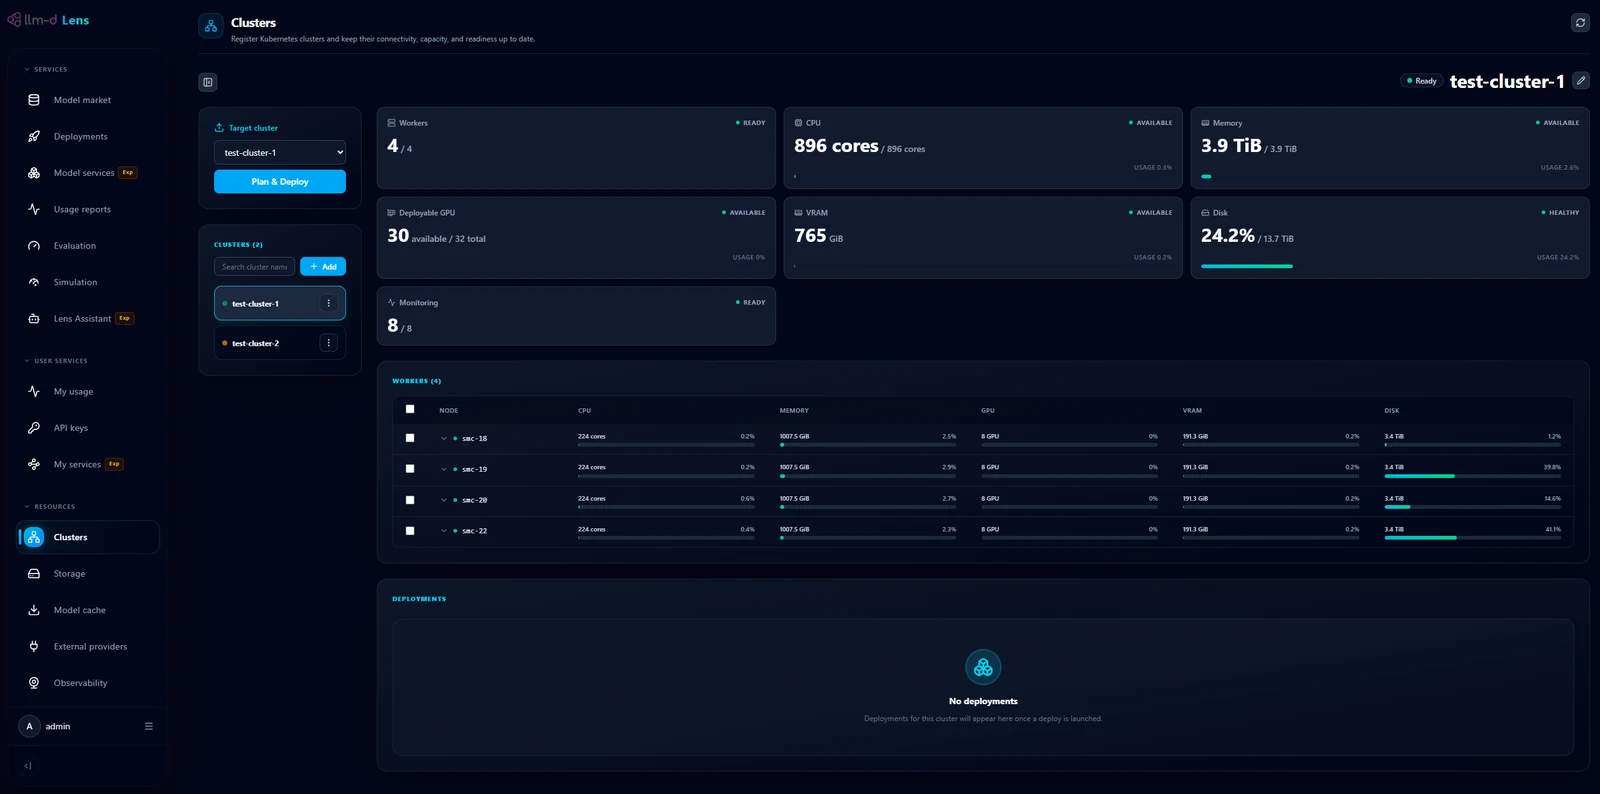
一键搭建并维护集群监控栈(Prometheus/Grafana), 用于查看 GPU 利用率和部署健康状况。
架构
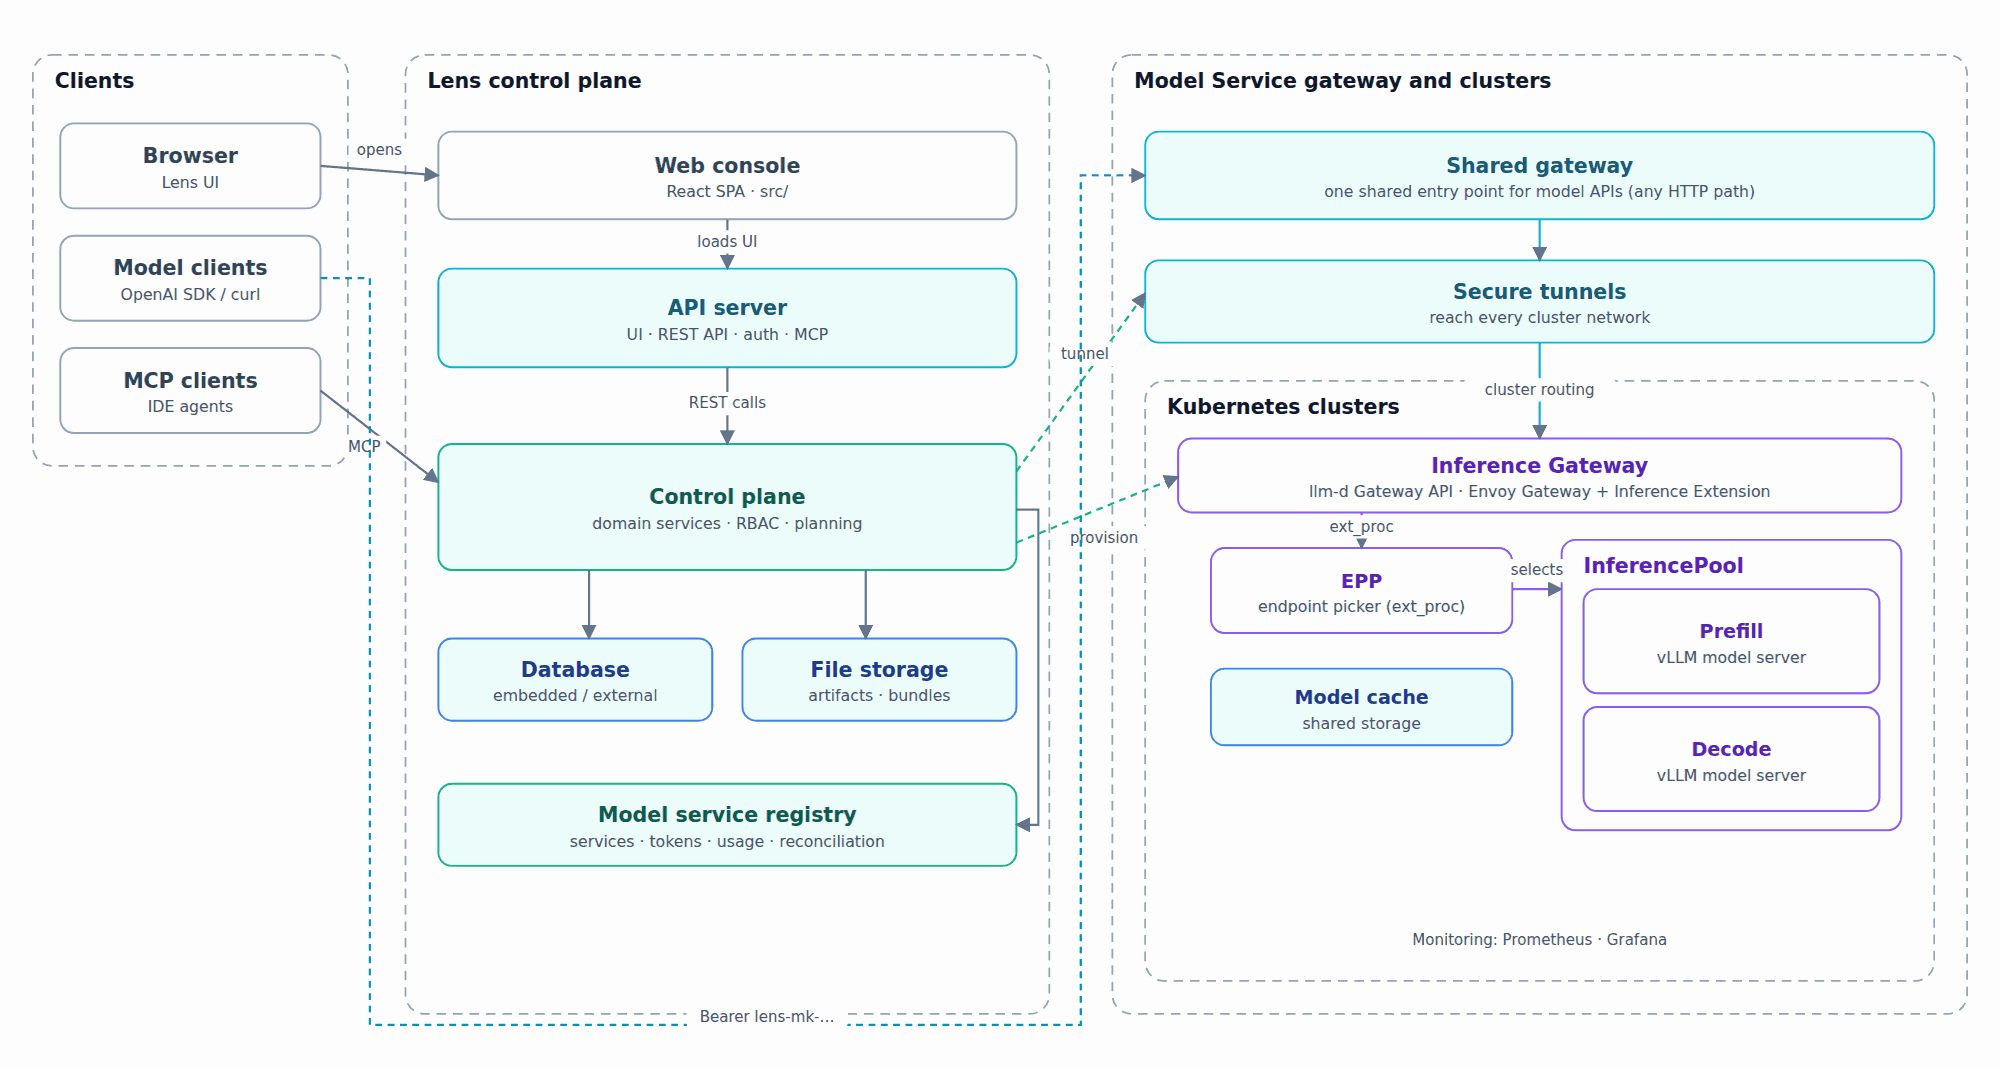
一台 Lens 服务器可以从统一的控制台管理任意数量的 Kubernetes 集群(无论是本地还是云端): 控制台通过同源 API 路由与应用层通信,应用层再将请求转发给负责各领域服务的控制平面, 该控制平面将状态持久化到数据库,并直接驱动集群、存储与模型服务数据面。 访问控制和审计日志都在控制平面中强制执行,因此每个页面——部署、评估、模拟和模型服务—— 都遵循同一套按集群划分的权限。